Minggu, 13 Maret 2022

5 ARTIKEL (JURNAL ATAU PROCEEDING) YANG MEMBAHAS HASIL DATA MINING

 Nama Kelompok 4 :

1. Husna Aprillia Damayanti (12119852)

2. Novi Puji Lestari (14119838)

3. Reistika Pravitasari (15119415)

4. Renancy Lyna Saraswaty (15119430)


JURNAL 1

PENERAPAN DATA MINING PADA PENJUALAN MAKANAN DAN MINUMAN MENGGUNAKAN METODE ALGORITMA NAIVE BAYES

1. Type Data

Bulan

Makanan

Minuman

Februari

11373000

3791000

Maret

12750000

4250000

April

2550000

850000

Mei

3060000

1020000

Juni

15300000

5100000

Juli

17850000

5950000

Agustus

25500000

8500000

September

38250000

12750000

Oktober

22950000

7650000

November

22950000

7650000

Desember

22236xxx

7412xxx


    Mendeskripsikan data tersebut bertujuan untuk memahami informasi lebih lanjut mengenai atribut dari data yang akan diolah dalam pengklasifikasian penjualan pada restoran Makan Barbeque Sepuasnya.

2. Atribut

Tahapan ini bertujuan memilih atribut yang dianggap sebagai atribut yang berpengaruh terhadap klasifikasi penjualan makanan dan minuman.

Atribut

Makanan

Minuman


3. Type Atribut

Selanjutnya mendeskripsikan data tersebut yang bertujuan untuk memahami informasi lebih lanjut mengenai atribut dari data yang akan diolah dalam pengklasifikasian penjualan pada restoran Makan Barbeque Sepuasnya.

Atribut

Jenis

Keterangan

Makanan

Numeric

Nominal Penjualan Makanan

Minuman

Numeric

Nominal Penjualan Minuman


4. Preprocessing

Pada tabel dibawah ini terdapat data yang berbeda tipe data dan data tersebut tidak valid atau salah dalam penulisan.

  • Tabel Data Yang Tidak Relevan 

  •     Tabel Hasil Cleansing Data

Data yang berjenis numerik seperti makanan dan minuman harus dilakukan inisialisasi data terlebih dahulu ke dalam bentuk nominal makanan dan nominal minuman. Untuk melakukan inisialisasi dapat dilakukan dengan sebagai berikut :

  • Makanan yang terjual dengan nominal lebih dari 15.000.000 diberi inisial pada atribut Keterangan Makanan “Untung”,
  • Makanan yang terjual dengan nominal kurang dari atau sama dengan 15.000.000 diberi inisial pada atribut Keterangan Makanan “Rugi”.
  • Minuman yang terjual dengan nominal lebih dari 5.000.000 diberi inisial pada atribut Keterangan Minuman “Untung”,
  • Minuman yang terjual dengan nominal kurang dari atau sama dengan 5.000.000 diberi inisial pada atribut keterangan Minuman “Rugi”,

Berikut adalah dataset penjualan makanan dan minuman yang telah dilakukan inisialisasi yang terdapat pada gambar dibawah ini.

Bulan

Makanan

Keterangan Makanan

Minuman

Keterangan Minuman

Februari

11373000

Rugi

3791000

Rugi

Maret

12750000

Rugi

4250000

Rugi

April

2550000

Rugi

850000

Rugi

Mei

3060000

Rugi

1020000

Rugi

Juni

15300000

Untung

5100000

Untung

Juli

17850000

Untung

5950000

Untung

Agustus

25500000

Untung

8500000

Untung

September

38250000

Untung

12750000

Untung

Oktober

22950000

Untung

7650000

Untung

November

22950000

Untung

7650000

Untung

Desember

22236000

Untung

7412000

Untung


5. Task Mining
  • Menghitung Jumlah Kelas

Dari jumlah cell (data) dari masing masing kelas dibagi dengan keseluruhan cell (data) maka akan mendapatkan probabilitas prior. Berikut perhitungan probabilitas prior berdasarkan persamaan :

P (Keterangan Makanan, Untung) = 7/22 = 0,318

P (Keterangan Makanan, Rugi) = 4/22 = 0,182

P (Keterangan Minuman, Untung) = 7 22 = 0,318

P (Keterangan Minuman, Rugi) = 4/22 = 0,182

Kelas

Sub Kelas

Jumlah

Probabilitas Kelas P (C)

Keterangan

Untung

7

0,318

Makanan

Rugi

4

0,182

Keuntungan

Untung

7

0,318

Minuman

Rugi

4

0,182

      Total                                     22                         1,000

  • Menghitung Jumlah Kasus Dari Setiap Kelas

Untuk mencari nilai probabilitas posterior/jumlah kasus kejadian dari setiap kelas yaitu jumlah atribut dengan kelas “Keuntungan Makanan” dan kelas “Keuntungan Minuman” kemudian dibagi dengan jumlah kelas yang ada.

Jumlah Kejadian

Bulan

Keterangan Makanan

Keterangan Minuman

Untung

Rugi

Untung

Rugi

Februari

0

1

0

1

Maret

0

1

0

1

April

0

1

0

1

Mei

0

1

0

1

Juni

1

0

1

0

Juli

1

0

1

0

Agustus

1

0

1

0

September

1

0

1

0

Oktober

1

0

1

0

November

1

0

1

0

Desember

1

0

1

0

Total

11

11

Probabilitias P (F|C)

Bulan

Keterangan Makanan

Keterangan Minuman

Untung

Rugi

Untung

Rugi

Februari

0

0,09

0

0,09

Maret

0

0,09

0

0,09

April

0

0,09

0

0,09

Mei

0

0,09

0

0,09

Juni

0,09

0

0,09

0

Juli

0,09

0

0,09

0

Agustus

0,09

0

0,09

0

September

0,09

0

0,09

0

Oktober

0,09

0

0,09

0

November

0,09

0

0,09

0

Desember

0,09

0

0,09

0

Total

1,000

1,000

  • Mengalikan Semua Variabel Kelas

Perhitungan nilai probabilitas prior dan probabilitas posterior yang telah dilakukan akan digunakan sebagai model yang akan digunakan sebagai acuan untuk menentukan data testing. Di bawah ini merupakan contoh data testing yang akan di hitung probabilitasnya.

1)  Untuk semua atribut kelas Keterangan Makanan = “Untung”

P (X | Keterangan Makanan = “Untung”) = 7/11 = 0.636

2)  Untuk semua atribut kelas Keterangan Makanan = “Rugi”

P (X | Keterangan Makanan = “Rugi”) = 7/11 = 0,363

3)  Untuk semua atribut kelas Keterangan Minuman = “Untung”

P (X | Keterangan Minuman = “Untung”) = 7/11 = 0.636

4)  Untuk semua atribut kelas Keterangan Minuman = “Rugi”

P (X | Keterangan Minuman = “Rugi”) = 4/11 = 0,363

5)  Perkalian probabilitas prior dengan semua atribut Keterangan Makanan = “Untung”

P (Ci | Keterangan Makanan = “Untung”) × P (X | Keterangan Makanan = “Untung”) = 0,318 × 0,636 = 0,202

6)  Perkalian probabilitas prior dengan semua atribut Keterangan Makanan = “Rugi”

P (Ci | Keterangan Makanan = “Rugi”) × P (X | Keterangan Makanan = “Rugi”) = 0,182 × 0,363 = 0,066

7)  Perkalian probabilitas prior dengan semua atribut Keterangan Minuman = “Untung”

P (Ci | Keterangan Minuman = “Untung”) × P (X | Keterangan Minuman = “Untung”) = 0,318 × 0,636 = 0,202

8)  Perkalian probabilitas prior dengan semua atribut Keterangan Minuman = “Rugi”

P (Ci | Keterangan Minuman = “Rugi”) × P (X | Keterangan Minuman = “Rugi”) = 0,182 × 0,363            = 0,066

  •     Membandingkan Hasil dari Setiap Kelas

Kelas

Probabilitas

 P (Keterangan Makanan | Untung)

0,202

P (Keterangan Makanan | Rugi)

0,066

P (Keterangan Minuman | Untung)

0,202

P (Keterangan Minuman | Rugi)

0,066

Dari data testing yang sudah diuji menghasilkan kelas P (Keterangan Makanan | Untung) dan P (Keterangan Minuman | Untung) memiliki nilai probabilitas tertinggi diantara kelas lainnya, sehingga dapat diambil kesimpulan bahwa makanan dan minuman memiliki probabilitas lebih tinggi.

6. Hasil yang diperoleh

Hasil pengujian berdasarkan Accurancy

Skenario

2

3

4

5

6

7

8

9

10

Fold

fold

fold

fold

fold

fold

fold

fold

fold

Accurancy

85,92

88,73

88,03

87,32

88,38

87,68

86,9

88,03

88,3

Hasil pengujian berdasarkan Precision

Skenario

2

3

4

5

6

7

8

9

10

fold

fold

fold

fold

fold

fold

fold

fold

fold

Precision

45,56

64,62

56,37

54,43

58,38

47,78

56,8

58,03

66,37

Hasil pengujian berdasarkan Recall

Skenario

2

3

4

5

6

7

8

9

10

Fold

fold

fold

fold

fold

fold

fold

fold

fold

Recall

45,12

45,72

43,13

43,52

41,36

42,78

44,9

44,83

48,7

Hasil pengujian berdasarkan Nilai Kappa

Skenario

2

3

4

5

6

7

8

9

10

fold

fold

fold

fold

fold

fold

fold

fold

fold

Kappa

0,392

0,425

0,453

0,21

0,34

0,444

0,42

0,411

0,431

7. Tools yang digunakan

  • Algoritma Naive Bayes

Dalam teorema Bayes, probabilitas dapat dinyatakan sebagai berikut :

Diketahui :

X = bukti, H = hipotesis, P(H|X) adalah probabilitas bahwa hipotesis H benar untuk bukti X atau dengan kata lain P(H|X) merupakan probabilitas posterior H dengan syarat X. P(X|H) adalah probabilitas bahwa hipotesis X benar untuk bukti H atau dengan kata lain P(X|H) merupakan probabilitas posterior X dengan syarat H. P(H) adalah probabilitas prior hipotesis H, dan P(X) adalah probabilitas prior bukti X.

  • Knowledge Discovery in Database (KDD)

Adalah metode dan cara mendapatkan sebuah informasi melalui basis data yang telah tersedia.

KESIMPULAN

  1. Penelitian ini dilakukan untuk mengklasifikasikan penjualan makanan dan minum pada restoran Makan Barbeque Sepuasnya menggunakan algoritma Naïve Bayes dengan metodologi KDD (Knowledge Discovery in Database). Dari hasil perhitungan klasifikasi menggunakan algoritma Naïve Bayes adalah keterangan makanan untung dan keterangan minuman untung yang lebih besar probabilitasnya.
  2. Hasil pengujian klasifikasi algoritma Naïve Bayes dari sembilan skenario pengujian yang telah dibuat dengan cross validation, menghasilkan performa terbaik pada skenario pengujian dengan menggunakan 3 fold yang menghasilkan performa terbaik dengan nilai accuracy sebesar 88,73%,  precision sebesar 64,42%, recall sebesar 45,41% dan dengan nilai kappa yang diperoleh sebesar 0,451 yang termasuk kedalam kategori cukup. Berdasarkan hasil tersebut maka, model yang dihasilkan oleh algortima Naïve Bayes ini konsisten.

JURNAL 2

Penggunaan Data Mining dalam Kegiatan Sistem Pembelajaran Berbantuan Komputer

    Data mining merupakan suatu langkah dalam Knowledge Discovery in Databases (KDD). Knowledge discovery sebagai suatu proses terdiri atas pembersihan data (data cleaning), integrasi data (data integration), pemilihan data (data selection), transformasi data (data transformation), data mining, evaluasi pola (pattern evaluation) dan penyajian pengetahuan (knowledge presentation). Data mining mengacu pada proses untuk menambang (mining) pengetahuan dari sekumpulan data yang sangat besar. Kerangka proses data mining tersusun atas tiga tahapan, yaitu pengumpulan data (data collection), transformasi data (data transformation), dan analisis data (data analysis).

    Proses tersebut diawali dengan preprocessing yang terdiri atas pengumpulan data untuk menghasilkan data mentah (raw data) yang dibutuhkan oleh data mining, yang kemudian dilanjutkan dengan transformasi data untuk mengubah data mentah menjadi format yang dapat diproses oleh data mining, misalnya melalui filtrasi atau agregasi. Hasil transformasi data akan digunakan oleh analisis data untuk membangkitkan pengetahuan dengan menggunakan teknik seperti analisis statistik, machine learning, dan visualisasi informasi.

    Sistem pembelajaran berbantuan komputer (computer aided learning system) dapat diimplementasikan sebagai sistem tutorial berbasis web (web-based tutoring tool) atau sistem tutorial cerdas (intelligent tutoring system). Dalam sistem tutorial berbasis web maupun sistem tutorial cerdas, setiap interaksi siswa dengan sistem akan dicatat dalam suatu basis data dalam bentuk web log atau model siswa (student model). Setelah sistem tersebut digunakan dalam proses pembelajaran selama jangka waktu tertentu, maka akan terkumpul sejumlah besar data. Kumpulan data tersebut dapat diproses lebih lanjut dengan data mining untuk memperoleh pola baru yang dapat digunakan untuk meningkatkan efektifitas dalam proses pembelajaran.
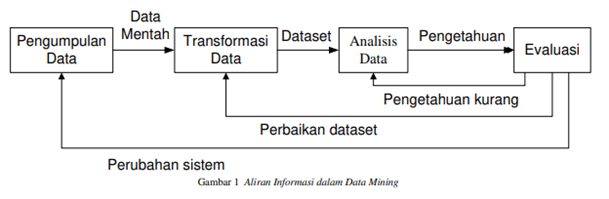

    Gambar 1 memperlihatkan diagram yang menggambarkan aliran informasi dalam proses data mining. Proses data mining pada gambar 1 ditunjukkan sebagai proses yang iteratif. Hasil evaluasi pengetahuan yang dihasilkan data mining dapat menimbulkan kebutuhan pengetahuan yang lebih lengkap, perbaikan kumpulan data (dataset) atau perubahan pada sistem.

  • Data yang digunakan:
- Type Data

Metode Algoritma association rule (AR)

    Algoritma association rule (AR) digunakan untuk menemukan hubungan antar nilai tertentu dari atribut nominal dalam suatu dataset. Aturan yang dihasilkan dapat ditulis dalam bentuk “if-then” dengan mempertimbangkan besaran support dan confidence untuk menilai reliabilitas aturan.

Classification

    Teknik classification bekerja dengan mengelompokkan data berdasarkan data training dan nilai atribut klasifikasi. Aturan pengelompokan tersebut akan digunakan untuk klasifikasi data baru ke dalam kelompok yang ada. Classification dapat direpresentasikan dalam bentuk pohon keputusan (decision tree). Setiap node dalam pohon keputusan menyatakan suatu tes terhadap atribut dataset, sedangkan setiap cabang menyatakan hasil dari tes tersebut. Pohon keputusan yang terbentuk dapat diterjemahkan menjadi sekumpulan aturan dalam bentuk IF condition THEN outcome.

Clustering

    Teknik clustering bekerja dengan mencari kemiripan di antara objek dengan memperhatikan karakteristik objek, sekelompok objek yang mirip akan termasuk ke dalam satu cluster. Teknik yang dapat digunakan untuk melakukan clustering antara lain algoritma k-means atau algoritma kmedoids

- Atribut
    Dataset dapat dikelompokkan secara vertikal sebagai kumpulan atribut dan secara horisontal sebagai kumpulan instans. Setiap atribut mempunyai tipe data, yang dapat berupa numerik, teks, atau bentuk lainnya. Jika domain nilai suatu atribut berhingga, maka disebut atribut nominal. Suatu instans adalah data yang dihasilkan dari suatu kejadian di dunia nyata, yang dicatat dalam beberapa atribut.


- Type Atribut
    Sistem pembelajaran berbantuan komputer (computer aided learning system) dapat diimplementasikan sebagai sistem tutorial berbasis web (web-based tutoring tool) atau sistem tutorial cerdas (intelligent tutoring system). Dalam sistem tutorial berbasis web maupun sistem tutorial cerdas, setiap interaksi siswa dengan sistem akan dicatat dalam suatu basis data dalam bentuk web log atau model siswa (student model). Setelah sistem tersebut digunakan dalam proses pembelajaran selama jangka waktu tertentu, maka akan terkumpul sejumlah besar data. Kumpulan data tersebut dapat diproses lebih lanjut dengan data mining untuk memperoleh pola baru yang dapat digunakan untuk meningkatkan efektifitas dalam proses pembelajaran.
  • Preprocessing
    Proses tersebut diawali dengan preprocessing yang terdiri atas pengumpulan data untuk menghasilkan data mentah (raw data) yang dibutuhkan oleh data mining, yang kemudian dilanjutkan dengan transformasi data untuk mengubah data mentah menjadi format yang dapat diproses oleh data mining, misalnya melalui filtrasi atau agregasi.
  • Task Mining
Klasifikasi, regresi, clustering, peringkasan, pemodelan kebergantungan, atau deteksi perubahan dan deviasi.
  • Hasil
    Hasil transformasi data akan digunakan oleh analisis data untuk membangkitkan pengetahuan dengan menggunakan teknik seperti analisis statistik, machine learning, dan visualisasi informasi. Analisis data hasil pembelajaran dapat dilakukan dengan menerapkan teknik algoritma association rules, classification, dan clustering untuk menghasilkan pengetahuan yang dapat membantu guru dalam mengelola kelasnya dengan memahami cara belajar siswa, dan memberikan umpan balik proaktif kepada siswanya.
  • Tools yang digunakan
    Menggunakan Knowledge Discovery In Databases (KDD)

KESIMPULAN

    Penerapan data mining dalam sistem pembelajaran berbantuan komputer diawali dengan pengumpulan data, yang dilanjutkan dengan transformasi data, dan diakhiri dengan analisis data. Pada pengumpulan data, harus didefinisikan suatu model interaksi antara siswa dengan sistem untuk menetapkan data yang harus dicatat dari suatu proses pembelajaran. Model interaksi siswa pada sistem tersebut dapat tersusun atas beberapa lapisan untuk memungkinkan pemerolehan data pada tingkat granularitas yang berbeda.

    Proses transformasi data mengubah data mentah menjadi dataset yang siap dianalisis. Transformasi dapat dilakukan pada instans dataset melalui proses filtrasi, maupun pada atribut dari dataset melalui filtrasi ataupun konversi. Analisis data hasil pembelajaran dapat dilakukan dengan menerapkan teknik algoritma association rules, classification, dan clustering untuk menghasilkan pengetahuan yang dapat membantu guru dalam mengelola kelasnya dengan memahami cara belajar siswa, dan memberikan umpan balik proaktif kepada siswanya.

JURNAL 3

PREDIKSI POTENSI PENJUALAN PRODUK DELIFRANCE DENGAN METODE NAIVE BAYES DI PT. PANGAN LESTARI

Abstrak

    PT. Pangan Lestari adalah perusahaan pemasok, dalam kesehariannya memiliki permasalahan yaitu dalam memprediksi barang yang laku berdasarkan hasil penjuala. Penggunaan data mining, dalam hal ini adalah berupa Metode Naïve Bayes sangat membantu dalam prediksi berapa stok yang disiapkan dan produk apa saja yang tidak laku. Dengan adanya bantuan alat aplikasi ini diharapkan penjualan akan meningkat karena konsumen senang belanja di sini karena barang yang akan di beli selalu tersedia, jenis variannya, dan selalu baru, belum kadaluarsa.

Kata kunci:Penjualan, Metode Naive Bayes, data mining
  • Data yang digunakan:
- Type Data

Metode Algoritma Naive Bayes

    Naive Bayes merupakan teknik prediksi berbasis probabilitas sederhana yang berdasarkan pada penerapan teorema bayes dengan asumsi independensi yang kuat. Dengan kata lain, dalam Naive Bayes menggunakan model fitur independen, maksud independen yang kuat pada fitur adalah bahwa data tidak berkaitan dengan data yang lain dalam kasusyang sama ataupun atribut yang lain.

Persamaan dari Teorema Bayes adalah :

Keterangan :

X : Data sampel dengan calass ( label ) yang tidak di ketahui.

H : Hipotesa bahwa X adalah data dengan class (label).

P ( H | X ) : Pobalitas H berdasarkan kondisi

X.P (H) = Peluang dari hipotesa H.

P(X|H) : Peluang data sampel X, bila diasumsikan bahwa hipotesa benar.P (X) = Peluang data sampel yang diamati.

- Atribut
    Dataset yang digunakan pada penelitian ini mengunakan data penjualan dari PT.Pangan Lestari sebanyak 3 atribut dan 300 data. atribut tersebut terdiri darinama customer, wilayah, nama barang. Data dan atribut tersebut digunakan untuk memprediksi material yang sering di order dan mencari seberapa besar nilai akurasi algoritma naïve bayes. Data dan atribut tersebut digunakan untuk memprediksi material yang sering di order dan mencari seberapa besar nilai akurasi algoritma naïve bayes

-Type Atribut
    Tahap Pertama, penentuan data yang akan diolah pada penelitian ini Berikut pada tabel 2 merupakan tabel atribut data penelitian dari dataset.

    Tahap Kedua, melakukan konversi data. Data dengan atribut yang telah dipilih kemudian dikonversikan untuk memudahkan proses Data Mining pada sebagian atribut, karena data akan diproses dengan tools bantu Data Mining.

  • Preprocessing yang digunakan

    Knowledge Discovery in Databases (KDD) merupakan sekumpulan proses untuk menemukan pengetahuan yang bermanfaat dari data. KDD terdiri dari serangkaian langkah perubahan, termasuk data preprocessing dan juga post processing. Data propecessing merupakan langkah untuk mengubah data mentah menjadi format yang sesuai untuk tahap analisis berikutnya. Selain itu data preprocessing juga digunakan untuk membantu dalam pengenalan atribut dan data segmen yang relevan dengan task data mining. Istilah Data mining dan Knowledge Discovery in Databases (KDD) sering kali digunakan secara bergantian untuk menjelaskan proses penggalian informasi tersembunyi dalam suatu basis data yang besar.

Gambar 1. Proses Knowledge Discovery in Databases (KDD)

1. Data Selection

Pemilihan atau seleksi data dari sekumpulan data operasional perlu dilakukan sebelum tahap penggalian informasi dalam knowledge data discovery dimulai. Data hasil seleksi yang akan digunakan untuk proses Data mining, disimpan dalam suatu berkas, terpisah dari basis data operasional Sebelum proses Data mining dapat dilaksanakan, perlu dilakukan proses cleaning pada data yang menjadi fokus KDD. Proses cleaning mencakup antara lain membuang duplikasi data, memeriksa data yang inkosisten, dan memperbaiki kesalahan pada data, seperti kesalahan cetak (tipografi). Juga dilakukan proses enrichment, yaitu proses memperkaya data yang sudah ada dengan data atau informasi lain yang relevan dan diperlukan KDD, seperti data atau informasi eksternal. 

2. Transformation

Coding adalah proses tranformasi pada data yang telah dipilih, sehingga data tersebut sesuai untuk proses data mining. Proses coding dalam KDD merupakan proses kreatif dan sangat tergantung pada jenis atau pola informasi yang akan dicari dalam basis data. 

3. Data mining

Data mining adalah proses mencari pola atau informasi menarik dalam data terpilih dengan menggunakan teknik atau metode tertentu. Teknik, metode, atau algoritma dalam Data mining sangatbervariasi. Pemilihan metode atau algoritma yang tepat sangat bergantung pada tujuan dan proses KDD secara keseluruhan. 

4. Interpretation / Evaluation

Pola informasi yang dihasilkan dari proses data mining perlu ditampilkan dalam bentuk yang mudah dimengerti oleh pihak yang berkepentingan. Tahap ini merupakan bagian dari proses KDDyang disebut interpretation. Tahap ini mencakup pemeriksaan apakah pola atau informasi yang ditemukan bertentangan dengan fakta atau hipotesis yang ada sebelumnya.

  • Hasil yang diperoleh

Hasil Penelitian,sebagai berikut :

- Perhitungan Naive Bayes

Perhitungan Naïve Bayes dilakukan dengan menghitung menggunakan data yang diambil dari data penjualan PT.Pangan Lestari sebanyak 3 atribut dan 300 data. Kriteria yang digunakan adalah sebagai berikut :

- Pengujian Naive Bayes

Pengujian pertama ini akan menggunakan satu algoritma yakni naïve baye tanpa menggunakan metode optimasi dalam melakukan klasifikasi data sebanyak 1 dataset. Berikut ini model pengujian yang digunakan dapat dilihat pada tabel …. di bawah ini :

Tabel 3. Data Customer, dan wilayah perdagangan

Nama Customer

GRAN MELIA JAKARTA, HOTEL, THE MARGO, HOTEL, SWISS BELINN KEMAYORAN, ART HOTEL, ASTON HOTEL - ANYER BEACH, ASTON HOTEL - PLUIT – DM, ASTON HOTEL - RASUNA SAID, ASTON IMPERIAL HOTEL – BEKASI, ASTON SENTUL LAKE RESORT & CONFERENCE, BEST SINAR NUSANTARA, PT, BEST WESTERN HOTELKUNINGAN, FAVE CILILITAN, HOTEL, GRAND MERCURE KEMAYORAN, HOTEL, GRANDHIKA, HOTEL, HARISTON HOTEL & SUITES, HORISON CILEDUG, IBIS STYLE GAJAH MADA, KERATON HOTEL, NOVOTEL GOLF RESORT & CONVENTION CENTRE HOTEL, ROYAL KUNINGAN HOTEL, POP HOTEL, OLYMPIC PREMIER, HOTEL, THE ALANA HOTEL & CONFERENCE SENTUL CITY, THE GROVE SUITE HOTEL, THE RITZ CARLTON HOTEL-KUNINGAN

Penjual / Wilayah

JKT FS1H, JKT FS2H, JKT FS3H

Kode Barang

IDT76543, IDT78126, IDT78192, IDT78463, IDT78566, IDT78622, IDT78628, IDT78630, IDT78632, IDT78644, IDT78651, IDT78654, IDT78655, IDT78662, IDT78688

Status

LAKU, SEDANG, TIDAK LAKU

 - Menghitung Probabilitas akhir setiap kelas

Menghitung probabiitas akhir pada setiap kelas, perlu menggunakan data training yang terdapat pada tabel 6 dan mengubahnya menjadi nilai yang sudah ditentukan pada perhitungan probabilitas masing- masing atribut, dari masing masing atribut dan nilai probabilitas kelas dikalikan. dari hasil yang sudah ditentukan pada tiap kelas, bandingkan nilai yang paling tinggi.jika kelas “LAKU” bernilai lebih besar maka hasilnya “LAKU”. Begitu pula dengan “SEDANG” dan “TIDAK LAKU”.

- Implementasi Klasifikasi NaïveBayes pada RapidMiner

Perhitungan yang telah dilakukan diatas sesuai untuk menentukan kelulusan dengan metode Naïve Bayes. Setelah melakukan perhitungan manual terhadap data training dan data testing, langkah selanjutnya pembuktian dengan menggunakan RapidMiner. Pembuktian perhitungan manual Naïve Bayes terhadap data training dan data testing, akan dilakukan perhitungan menggunakan RapidMiner. RapidMiner yang digunakan adalah versi 7.6

Gambar 4. Proses RapidMiner pengujian data traning terhadap data testing dalam menentukan prediksi.


Gambar 5. Hasil Prediksi RapidMiner

Gambar 5. Hasil Prediksi dimana data testing menggunakan sample acak awal dan akhir data yang digunakan dalam penelitian ini.

Pengujian dengan metode Naïve Bayes menggunakan dataset Penjualan. Hasil yang didapatkan pengujian ini mendapatkan hasil akurasi sebesar 72,00% dengan nilai presisi serta recall masing-masing kelas dapat dilihat pada gambar 8 berikut ini :

Gambar 6. Hasil Accuracy RapidMiner

  • Tools / Aplikasi yang digunakan

    RapidMiner merupakan suatu perangkat lunak yang bertujuan untuk melakukan analisis terhadap data mining, text mining dan analisis prediksi yang bersifat terbuka (open source) dan menggunakan berbagai teknik deskriptif dan prediksi dalam memberikan wawasan kepada pengguna sehingga dapat membuat keputusan yang paling baik.RapidMiner ditulis menggunakan bahasa java sehingga dapat bekerja di semua sistem operasi. RapidMiner memiliki kurang lebih 500 operator data mining, termasuk operator untuk input, output, data preprocessing dan visualisasi. RapidMiner merupakan software yang berdiri sendiri untuk analisis data sebagai mesin data mining yang dapat diintegrasikan pada produknya sendiri.

    RapidMiner sebelumnya bernama YALE (Yet Another Learning Environment), dimana versi awalnya mulai dikembangkan pada tahun 2001 oleh RalfKlinkenberg, Ingo Mierswa, dan SimonFischer di Artificial Intelligence Unit dari University of Dortmund. RapidMiner didistribusikan di bawah lisensi AGPL (GNU Affero General Public License) versi 3.Hingga saat ini telah ribuan aplikasi yang dikembangkan menggunakan RapidMiner di lebih dari 40negara.RapidMiner sebagai softwareopen source untuk data mining tidak perlu diragukan lagi karena software ini sudah terkemuka didunia.

    RapidMiner menempati peringkat pertama sebagai software data mining pada polling oleh KDnuggets, sebuah portal data mining pada tahun 2010-2011. RapidMiner menyediakan GUI (Graphic User Interface) untuk merancang sebuah pipeline analitis. GUI ini akan menghasilkan fileXML(Extensible Markup Language) yang mendefenisikan proses analitis keinginan pengguna untuk diterapkan ke data. File ini kemudian dibaca oleh RapidMiner untuk menjalankan analisa secara otomatis.

RapidMiner memiliki beberapa sifat sebagai berikut.

  • Ditulis dengan bahasa pemegroman java sehingga dapatdijalankan di berbagai sistem operasi.
  • Representasi XML internal untuk memastikan formatstandar pertukaran data.
  • Bahasa scripting memungkinkan untuk eksperiman skalabesar dan otomatisasi eksperimen.
  • Konsep multi-layer untuk menjamin tampilan data yangefisien dan menjamin penangan data

KESIMPULAN

Berdasarkan pada hasil penelitian yang telah dilakukan maka dapat disimpulkan :

  1. Penerapan Algoritma Naïve Bayes untuk memprediksi potensi penjualan berdasarkan data set penjualan deliverance pada PT.Pangan Lestari dapat membantu perusahaan dalam memprediksi potensi penjualan.
  2. Berdasarkan data yang diperoleh, proses Data Mining membantu dalam penerapan metode 78 Volume 9 Nomor 1 September 2018 ISSN : 2407-3903 SIGMA – Jurnal Teknologi Pelita Bangsa Naïve Bayes dalam mendapatkan informasi dari hasil prediksi pada data penjualan delifrance di PT.Pangan Lestari dijadikan Data Mining. Sehingga dengan demikian metode Naïve Bayes ini berhasil memprediksi dengan presentase keakuratan sebesar 72,00 % dengan menggunakan data sebanyak 300. 3. Dari hasil yang diperoleh data penjualan delifrance dapat mengetahui tingkat dan volume penjualan barang PT. Pangan Lestari kepada para konsumen
JURNAL 4

Implementasi Data Mining dengan Algoritma Naïve Bayes pada Penjualan Obat

Hasil yang di peroleh dari data mining : Data mining merupakan suatu langkah dalan melakukan Knowledge Discovery in Databases (KDD). Knowledge discovery sebagai suatu proses terdiri atas pembersihan data (data cleaning), integrasi (data integration), pemilihan data (data selection), transformasi data (data transformation), data mining, evaluasi pola (pattern evaluation) dan penyajian pengetahuan (knowledge presentation). Data mining mengacu pada proses untuk menambang (mining) pengetahuan dari sekumpulan data yang sangat besar untuk menghasilkan untuk menambah sebuah pengetahuan baru dari bidang tertentu.

    Pada data mining terdapat 3 bagia yaitu : Assosiation, Klasifikasi dan Clustering. Assosiation memiliki definisi sebuah proses yang digunakan untuk menemukan suatu yang terdapat pada nilai atribut dari sekumpulan data yang dimiliki, sedangkan klasifikasi adalah teknik yang di lakukan untuk memprediksi class atau propeti dari setiap instance data, dan Clustering sendiri memliki makna pengelompokan data tanpa berdasarkan kelas data tertentu ke dalam kelas objek yang sama sesuai dengan topik yang diangkat.

    Masalah yang harus di pecahkan pada penelitian ini adalah bagaimana menghasilkan nilai accuracy yang jauh lebih optimal untuk mengklasifikasikan prediksi Calon Nasabah potensial untuk di tawari produk lainya data set yang digunakan pada penelitian ini.

Pada gambar 1 hasil akhir dari data ini berupa kumpulan data yang sudah bersih atau tidak missing valuenya. 

Pengolahan data  : dataset ini dalam tahap preprocessing harus melalui 3 proses, yaitu:

  • Membuang duplikasi data
  • Memeriksa data yang inkonsisten
  • Memperbaiki kesalahan pada data.

Data testing yang digunakan AUC digunakan untuk mengukur kinerja diskriminatif dengan memperkirakan probbalitas output yang sudah di dapatkan hasilnya dari sampel yang sudah di pilih secara acak dari populasi positif atau negative semakin besar, nilai AUC, semakin kuat klasifikasi yang dihasilkan.


Hasil dan pembahasan

    Data yang digunakan dalam pengklasifikasian Calon Nasabah potensial terdiri dari 5.000 dataset 137, yang digunakan untuk data testing berdasarkan variabel yang tersedia. Klasifikasi dilakukan dengan menggunakan Software Rapidminer dengan versi 8 untuk mengolah data yang sudah di tentukan.

Evaluasi dan validasi data

    Validasi menggunakan 10 fold cross validation. Dimana dengan menggunakan teknik ini dengan membagi secara acak ke dalam tiap bagian dimana terdiri dari 10 bagian untuk setiap bagian akan dilakukan proses klasifikasi terlebih dahulu.
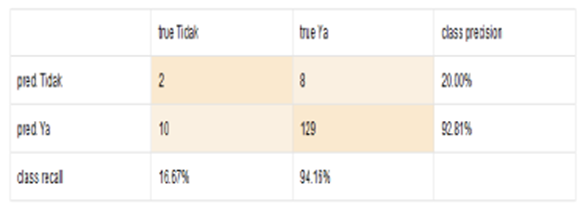

Pada gambar 4 merupakan perhitungan accuracy data menggunakan algoritma Naïve Bayes. Diketahui data training terdiri dari 150 record data, 10 data di klasifikasikan LAKU ternyata TIDAK LAKU, 2 data diprediksi TIDAK LAKU dan benar-benar TIDAK LAKU, 129 di prediksikan LAKU ternyata benar-benar LAKU serta 8 data diprediksikan TIDAK LAKU ternyta LAKU.

Model yang dihasilkan pada Algoritma Naïve Bayes menggunakan Rapidminner, yaitu :

- Type Data
    Data yang digunakan pada penelitian ini merupakan data sekunder, karena sumber data di peroleh melalui media perantara atau secara tidak langsung berupa yang berupa buku, catatan, bukti yang telah tervalidasi atau arsip baik yang di publikasikan maupun yang tidak di publikasikan secara umum yaitu 100 ribu data yang akan di pecah menjadi 80 persen data training dan 20 persen data testing.

- Atribut yang dimiliki 
    Dalam klasifikasi hanya terdapat satu atribut dari sekian banyaknya atribut yang bisa menjadi kemungkinan yang di sebut atribut target, sedangkan atribut lainya yang terdapat disebut atribut predictor

- Type Atribut
    type ii dengan naive bayes berbasis particle swarm optimization

- Dimensi
    Dimensi data yang tinggi dan Data yang heterogen dan berbeda sifat satu dengan yang lainya, setiap metode tersebut memiliki algoritma – algoritma yang terbaik yang dapat di gunakan untuk memproses data set yang ada. Namun dalam Penelitian diharapkan dapat membangun sebuah sistem dalam mengestimasi jenis vitamin untuk meningkatkan penjualan pada bulan berikutnya yang sesuai dengan data-data penjualan sebelumnya sehingga jenis vitamin yang diminati oleh pelanggan benar-benar tersedia pada apotek tersebut sehingga dapat membantu apotek dalam meningkatkan omset penjualannya menggunakan algoritma Naïve Bayes. Dimensi yang ada pada gambar yaitu 5 dimensi.

- Preprocessing
    Tahapan yang akan di lalui di bagi menjadi 3 yaitu preprocessing, seleksi fitur (Feature Selection) dan validation yang di dalamnya berisi sub proses training dan testing.

- Task Mining
    Assosiation, Klasifikasi dan Clustering. Assosiation memiliki definisi sebuah proses yang digunakan untuk menemukan suatu hubungan yang terdapat pada nilai atribut dari sekumpulan data yang dimiiki, sedangkan Klasifikasi adalah teknik yang dilakukan untuk memprediksi class atau properti dari setiap instance data, dan Clustering sendiri memliki makna pengelompokan data tanpa berdasarkan kelas data tertentu ke dalam kelas objek yang sama sesuai dengan topik yang diangkat.

    Data yang akan digunakan pada penelitian ini adalah 150 dataset. Penelitian ini di lakukan karena atas masalah mengetahi produk pada bulan sebelumnya agar dapat menentukan stok produk mana yang mesti di perbanyak menggunakan algoritma Naïve Bayes agar mengetahui nilai accuracy nya. sekitar 150 data yang telah diklasifikasikan berdasarkan variable yang ada.

  Masalah yang harus dipecahkan pada penelitian kali ini adalah, bagaimana menghasilkan nilai accuracy yang jauh lebih optimal untuk mengklasifikasikan prediksi Calon Nasabah Potensial untuk ditawari produk lainnya.

- Hasil


JURNAL 5

PENERAPAN DATA MINING DENGAN METODE KALSIFIKASI MENGGUNAKAN DECISION TREE DAN REGRESI

Abstrak

    Konversi Bahan Bakar Minyak (BBM) ke Bahan Bakar Gas (BBG) yang dilakukan pemerintah bermula atas melimpahnya gas di bumi Indonesia. kabupaten Cilacap melakukan survey terhadap masyarakat untuk menentukan masyarakat mana yang lebih diprioritaskan untuk mendapatkan bantuan pemberian kompor gas beserta tabungnya. Berdasarkan survey pada tahun 2010 di Kabupaten Cilacap Kecamatan Kroya terdapat 17 kelurahan dengan 28.131 data dengan 31 field atau kolom. Data diolah dengan beberapa tahapan yaitu : pengecekan data, integrasi data, target data, preprocessing, visualisasi, proses data mining, dan pengetahuan. Pada proses data mining dilakukan proses decision tree, regresi, dan k means untuk clustering yang ditampilkan dalam bentuk scatter plot. Berdasarkan decision tree maka diperoleh data kelurahan yang menjadi prioritas untuk diberi bantuan yaitu : Kelurahan Bajing Kulon, Kedawung, Pekuncen, dan Pesanggarahan. Atribut yang digunakan untuk proses regresi yaitu per kelurahan dengan variabel x yaitu pendidikan atau pekerjaan dan variabel y yaitu penghasilan.

Kata kunci: data mining, decision tree, regresi
  • Data yang digunakan
- Type Data
Klasifikasi data mining adalah penempatan objek-objek ke salah satu dari beberapa kategori yang telah ditetapkan sebelumnya. Klasifiksi banyak digunakan untuk memprediksi kelas pada suatu label tertentu, yaitu dengan mengklasifikasi data (membangun model) berdasarkan training set dan nilai-nilai (label kelas) dalam mengklasifikasikan atribut tertentu dan menggunakannya dalam mengklasifikasikan data yang baru. Pohon keputusan biasanya digunakan untuk mendapatkan informasi untuk tujuan pengambilan sebuah keputusan. Pohon keputusan dimulai dengan sebuah root node (titik awal) yang digunakan oleh user untuk mengambil tindakan. Berdasarkan node root ini, user memecahkan leaf node sesuai dengan algoritma decision tree. Regresi linier adalah metode statistika yang digunakan untuk membentuk model hubungan antara variabel terikat (dependen) dengan satu atau lebih variabel bebas (independen). Apabila banyaknya variabel bebas hanya ada satu, disebut sebagai regresi linier sederhana, sedangkan apabila terdapat lebih dari 1 variabel bebas, disebut sebagai regresi linier berganda.

- Atribut
Atribut yang digunakan untuk proses regresi yaitu per kelurahan dengan variabel x yaitu pendidikan atau pekerjaan dan variabel y yaitu penghasilan. Atribut Kategori, Kabupaten, Kecamatan, Pendidikan , Pekerjaan, Pengeluaran, Masak akan diubah menjadi numeric.

- Type Atribut

Tabel 1 Tabel Data Penduduk

Atribut

Keterangan

Kategori

Didalamnya mencakup data yang terdiri dari : Rumah Tangga tetap, Usaha Kecil Menengah (UKM), Rumah Tangga Musiman

Kelurahan

Mencakup 17 macam Kelurahan yang ada pada Kecamatan Kroya

Jenis Kelamin

Merupakan jenis kelamin penduduk yang bersangkutan

Pendidikan

Merupakan jenjang pendidikan akhir yang diselesaikan oleh penduduk yang bersangkutan

Pekerjaan

Jenis pekerjaan yang dilakoni oleh setiap penduduknya

Pengeluaran

Seberapa banyak pengeluaran yang dikeluarkan oleh setiap keluarga perbulannya

Jumlah Keluarga

Banyaknya jumlah anggota setiap keluarga

Masak

Dengan menggunakan apa setiap penduduknya memasak

Liter

Jumlah liter yang dihabiskan oleh penduduknya jika memasak dengan menggunakan kompor minyak

Rupiah

Jumlah pengeluaran untuk minyak tanah yang harus dibeli oleh penduduk yang memasak dengan menggunakan kompor minyak.


  • Preprocessing yang digunakan

    Preprocess Sebelum diproses data mining sering kali diperlukan preprocessing. Data preprocessing menerangkan tipe-tipe proses yang melaksanakan data mentah untuk mempersiapkan proses prosedur yang lainnya. Tujuannya preprocessing dalam data mining adalah mentransformasi data ke suatu format yang prosesnya lebih mudah dan efektif untuk kebutuhan pemakai, dengan indikator sebagai berikut :

  • ·         Mendapatkan hasil yang lebih akurat
  • ·         Pengurangan waktu komputasi untuk large scale problem
  • ·         Membuat nilai data menjadi lebih kecil tanpa merubah informasi yang dikandungnya.
  • ·         Terdapat beberapa metode yang digunakan untuk preprocessing seperti :

a.       Sampling, menyeleksi subset representatif dari populasi data yang besar.

b.      Diskretisasi, Bagian dari data reduksi tetapi memiliki arti penting tersendiri, terutama untuk data numerik.

c.       Remove missing

d.      Continuize

e.       Impute

f.     Feature selection

  • Hasil yang diperoleh

Penelitian yang dilakukan melalui beberapa proses yaitu :

        PreProcessing

PreProcessing yang dilakukan yaitu proses pembersihan data mengalami tiga tahap pembersihan yaitu: Incomplete, Noisy dan Inconsisten. Berikut dibawah ini penjelasan dan prosesnya.

·         Incomplete Pada tahap ini, penulis membersihkan data berdasarkan data yang tidak lengkap atau data yang tidak terisi. Kesimpulan dari tahap ini adalah pembersihan data, dalam artian bahwa jika attribute data tersebut kosong atau tidak terdapat nilai didalamnya maka attribute data tersebut akan dihapus. Hal tersebut di atas dikarenakan penulis tidak memiliki data pendukung untuk mengisi attribute data yang kosong.

·         Noisy dan Inkonsistensi Data Merupakan suatu data yang memiliki kelainan, hal ini dikarenakan karena kesalahan operator dalam memasukkan data kedalam database, permasalahan pada pentransmisian data, keterbatasan teknologi, atau tidak dilakukannya penyeragaman data, seperti data wilayah, jenis kelamin, dan lain sebagainya. Proses pembersihan data ini menggunakan suatu tools data mining yaitu Orange.

ü          Pengubahan Data menjadi Numeric

Pada langkah selanjutnya data yang sudah dibersihkan akan diubah value nya menjadi bentuk numeric, hal ini dimaksudkan agar pengolahan data pada MatLab dapat lebih mudah dan cepat, karena MatLab hanya memproses data-data numeric.

    Transformasi Data

Tahapan Transformasi data adalah pengubahan format data tersimpan menjadi bentuk standar format file yang sesuai dengan aplikasi yang akan digunakan. Pada penelitian kali ini, penulis menggunakan aplikasi MatLab untuk melakukan proses data mining dengan Proses Aturan Prediksi menggunakan Regresi Linear, aturan Klasifikasi menggunakan Decision Tree. Pengubahan atau Transformasi data ke dalam format file yang sesuai adalah mengubah format file data sebelumnya yang merupakan bentuk file Tab Delimited yaitu Text atau .txt menjadi bentuk .dat.

Penarikan Informasi

    Berdasarkan hasil yang didapat pada 3 langkah data mining diatas, maka dapat ditarik beberapa kesimpulan atau informasi yang dapat dijadikan pengetahuan untuk diambil suatu keputusan, informasi tersebut dapat dijabarkan sebagai berikut:

  1. Klasifikasi dengan Pohon Keputusan/Decision Tree. Berdasarkan proses software Orange dengan menggunakan widget Classification Tree Viewer dan Classification Tree Graph bahwa keputusan yang dapat diambil oleh kepala kecamatan tentang kelurahan yang akan diberikan bantuan dengan skala prioritas adalah Kelurahan Bajing Kulon, Kedawung, Pekuncen, Pesanggarahan dan seterusnya.
  2. Klasifikasi dengan Regresi Linear Untuk mendapatkan informasi yang dibutuhkan dalam pengambilan keputusan dengan menggunakan Regresi Linear maka data yang ada yaitu data Pada Kecamatan Kroya dengan 17 kelurahannya harus di pecah menjadi data per kelurahan saja. Data per Kelurahan inilah nantinya akan dihitung dengan regresi linear pada Aplikasi Data Mining yang Peneliti rancang, yang kemudian hasil dari proses tersebut satu per satu Kelurahan yang ada di Kecamatan Kroya akan dibandingan secara keseluruhan. Hasil dari regresi linear ini adalah mencari nilai dari Variabel Y terkecil di kelurahan yang ada.
  • Tools / Aplikasi yang digunakan

    Pada tahap ini proses pembersihan data dan pengintegrasian data  menggunakan dua tools yaitu, Microsoft Excell dan Orange.

    Pada penelitian kali ini, penulis menggunakan aplikasi MatLab untuk melakukan proses data mining dengan Proses Aturan Prediksi menggunakan Regresi Linear, aturan Klasifikasi menggunakan Decision Tree. Pengubahan atau Transformasi data ke dalam format file yang sesuai adalah mengubah format file data sebelumnya yang merupakan bentuk file Tab Delimited yaitu Text atau .txt menjadi bentuk .dat.

    Proses Aplikasi Prediksi pada Klasifikasi dengan Rumus Regresi linear untuk menentukan mana kelurahan yang memiliki prioritas untuk diberikan bantuan dari 17 kelurahan yang ada di kecamatan kroya.

KESIMPULAN

    Dapat disimpulkan bahwa dengan menggunakan decision tree prioritas kelurahan yang dapat diberi bantuan yaitu: Kelurahan Bajing Kulon, Kedawung, Pekuncen, dan Pesanggarahan.

    Proses pada regresi berdasarkan per kelurahan dengan atribut untuk variabel x adalah pekerjaan atau pendidikan dan atribut untuk variabel y adalah penghasilan.

    Terlepas dari penjelasan pada paragraph di atas, Peneliti sadari masih banyak kekurangan dalam penelitian ini, hal ini dikarenakan karena variable data yang terlalu luas dan proses pembersihan data yang memakan waktu lama, sehingga pemilihan proses data mining dengan penggunaan algoritma yang diterapkan mungkin memiliki kelemahan dalam keakuratan hasil data yang ada, tetapi hasil yang didapatkan tidak mengurangi keakuratan algoritma atau rumus yang diterapkan.

Referensi Jurnal

https://ejournal.upbatam.ac.id/index.php/jif/article/view/3755/2062

https://ejournal.bsi.ac.id/ejurnal/index.php/ji/article/view/6203

https://media.neliti.com/media/publications/224659-penggunaan-data-mining-dalam-kegiatan-si-f3afe53d.pdf

https://jurnal.pelitabangsa.ac.id/index.php/sigma/article/download/465/282

https://jurnal.umj.ac.id/index.php/jurtek/article/download/364/337

Selasa, 05 Oktober 2021

Dampak positif dan negatif Covid-19 bagi diri sendiri, keluarga, dan masyarakat sekitar!

Dampak Positif

                  -          Diri Sendiri :

Ø  Lebih menjaga kesehatan

Ø  Berolahraga

Ø  Saling menjaga kesehatan satu sama lain

-          Keluarga :

Ø  Lebih bisa menghargai dan meluangkan waktu bersama

Ø  Saling bekerjasama

Ø  Menukar cerita

Ø  Lebih menjaga kesehatan dengan pola akan, perbanyak minum vitamin

-          Masyarakat :

Ø  Bisa saling bergotong royong

Ø  Saling menjaga dan menghargai kesehatan untuk lingkungan masyarakat sekitar

Ø  Saling perduli satu sama lain


·         Dampak Negatif

-          Diri Sendiri :

Ø  Tidak bisa sebebas sebelum pandemi

Ø  Pembelajaran daring, jadi kurang paham

Ø  Tidak bisa berkumpul dengan teman-teman

-          Keluarga :

Ø  Tidak bisa sebebas sebelum pandemi

Ø  Jadi terhalang mau bersilahturahmi kerumah saudara

-          Masyarakat :

Ø  Masyarakat takut mengakses Rumah Sakit dan Puskesmas

Ø  Tidak bisa sebebas sebelum pandemi

Ø  Banyak pekerja yang dirumahkan atau PHK

Ø  Banyak masyarakat yang kekurangan ekonomi karna pandemi

Senin, 27 September 2021

Pelecehan dan Perundungan Terjadi di KPI Pusat. Lembaga Moral kok Darurat Moral

Pelecehan seksual sesama jenis dan perundungan diduga terjadi di Kantor KPI pusat. Kasus ini melibatkan satu pegawai dan tujuh pelaku yang bekerja di kantor yang sama.

Sebuah pesan berantai diterima sejumlah media melalui aplikasi pesan WhatsApp. Pesan itu memuat tulisan tentang dugaan pelecehan seksual sesama jenis dan perundungan yang terjadi di KPI Pusat. Pesan itu bahkan memuat banyak pernyataan korban tentang apa yang dialaminya selama bertahun-tahun bekerja sebagai pegawai KPI Pusat.

Berdasarkan berita yang beredar, kasus ini sudah berjalan sejak 2012. Pegawai berinisial MS sering menjadi korban perundungan atau bullying yang dilakukan sesama pegawai KPI Pusat. Mulai dari kerap disuruh membelikan makanan, diceburkan ke kolam, tasnya dilempar, hingga yang paling parah adalah ditelanjangi, difoto, dan alat kelaminnya dicoret menggunakan spidol.

Tepatnya pelecehan seksual mulai terjadi sekitar 2015. Suatu kali, menurut MS, pelaku perundungan dan pelecehan pernah memegangi kepala, tangan, kaki, dan menelanjangi korban. Di saat itulah pelaku juga mencoret alat kelaminnya dengan spidol. Rangkaian kejadian perundungan dan pelecehan seksual yang terjadi di tempat ia bekerja ini membuat MS mengalami trauma dan membuatnya berobat ke psikiater. Namun, kejadian ini terus berulang dan belum selesai.

“Kejadian itu membuat saya trauma dan kehilangan kestabilan emosi. Kok bisa pelecehan jahat macam begini terjadi di KPI Pusat?” tulis MS dalam pesan WhatsApp.

MS juga mengaku bahwa ia kerap berteriak di tengah malam karena trauma. Ia juga merasa tak lagi memiliki harga diri sebagai seorang pria, suami, dan kepala rumah tangga. Trauma ini juga menyebabkan MS mengalami penurunan fungsi tubuh berupa hipersekresi lambung karena trauma.


Korban sudah melapor, tapi responsnya tidak memuaskan.

Atas kejadian yang menimpa dirinya, MS sebenarnya telah melaporkan kejadian ini kepada Komnas HAM. Pihak Komnas HAM juga telah mengonfirmasi laporan korban dan menggolongkan perkara ini ke dalam kejahatan dan tindak pidana. Pada 2019, korban melaporkan perkara ini ke polisi. Sayangnya polisi menyarankan korban untuk menyelesaikan perkara ini dengan atasannya di KPI Pusat.

Setelah melapor, atasannya memindahkan MS ke ruangan lain untuk menghindari perundungan agar tidak terjadi lagi. Sayangnya, aduannya kepada atasan sempat bocor dan diketahui pelaku. Pelaku kembali merundung korban dengan mengatainya “manusia lemah” dan “pengadu”. Tas MS juga pernah dilempar, dan kursinya ditulisi “bangku ini tidak ada orangnya”. Hal ini terjadi selama bertahun-tahun dan diketahui oleh pegawai lain, namun respons orang-orang cenderung dingin karena mereka tidak kaget menyaksikan perundungan ini.

Bagi MS, berhenti sebagai pegawai KPI Pusat juga bukan solusi. Korban bukanlah orang yang harus pergi dan meninggalkan pekerjaan akibat rundungan yang diterimanya. Sebaliknya, seharusnya para perundunglah yang harus menerima konsekuensi secara profesional atas perbuatannya.


Bukan pertama kalinya KPI terlibat kontroversi.

Kejadian pelecehan dan perundungan yang melibatkan pegawai KPI Pusat membuat banyak netizen geram. Lembaga yang kerap membuat pernyataan kontroversial dan membingungkan ini justru kembali muncul dengan kisah buruk yang semakin menegaskan bahwa ada yang tidak beres disana. Sebelumnya, KPI terkenal dengan aturan penyensoran siaran yang ketat dan tidak masuk akal. Aturan seperti menyensor belahan dada pada serial animasi dan atlet dianggap kontras dengan absennya KPI Pusat untuk menindak kisah-kisah sinetron yang tidak masuk akal yang seharusnya dianggap merusak nalar penonton. Bahkan banyak masyarakat yang protes soal penertiban dan sanksi yang tidak diberikan terhadap penayangan pernikahan artis yang berlebihan.

Kasus ini juga sempat memunculkan dialog antara pegawai KPI Pusat dengan beberapa kreator konten Indonesia mengenai aturan penyensoran. Sayangnya, hasil dari dialog yang disiarkan langsung di televisi ini juga hanya melahirkan meme dan prasangka publik lainnya. Banyak pernyataan pegawai KPI Pusat yang dianggap tidak relevan.

Tidak hanya itu, kebijakan-kebijakan kontroversi lainnya seperti ngotot mengawasi Netflix dan YouTube, melarang karakter pria yang bergaya seperti wanita di televisi, hingga menganggap tubuh perempuan adalah sumber masalah moral. Tidak heran jika kemarahan masyarakat semakin terpicu akibat munculnya kasus perundungan dan pelecehan seksual. Nama dan kontak pelaku bahkan sempat tersebar di media sosial dan netizen ramai-ramai merisak balik pelaku.


KPI Pusat menanggapi.

Setelah kasus ini terkuak di media dan menjadi ramai, pihak KPI Pusat mengatakan bahwa lembaga mereka tidak menoleransi tindakan pelecehan seksual dan perundungan. Pihak mereka berjanji akan melakukan investigasi internal dan menindak para pelaku sesuai aturan yang berlaku jika memang mereka terbukti bersalah. Korban juga dikabarkan akan mendapatkan perlindungan, pendampingan hukum, dan pemulihan secara psikis.

Derita korban perundungan dan pelecehan seksual di KPI. Sudah laporannya “dicuekin” sejak lama, sekarang mau digugat balik pakai UU ITE. Sudah speak up, malah mau dipaksa give up.

“Yang terjadi cyber bullying baik kepada klien kami, maupun keluarga dan anak. Itu sudah keterlaluan menurut kami. Kami berpikir dan akan menimbang secara serius untuk melakukan pelaporan balik terhadap si pelapor,” kata Tegar Putuhena, kuasa hukum terduga pelaku pelecehan di KPI yang berinisial RT dan EO.

“Semua unsur-unsur pidana akan kami pelajari, misalnya pertama membuka identitas pribadi secara tanpa hak, itu sudah melanggar UU ITE. Kemudian dari situ disebarluaskan, terjadi ‘cyber bullying‘ terhadap keluarga, foto keluarga disebarkan itu juga akan kita pertimbangkan,” tegas Tegar.

Sementara itu, kelima terduga pelaku pelecehan seksual di KPI adalah RM alias O, FP, RE, RT, EO, dan CL. Kelimanya menjalani pemeriksaan di ruang unit Pelayanan Perempuan dan Anak (PPA) Polres Metro Jakarta Pusat, Kemayoran, sejak Senin (06/09) pukul 11.00 WIB.

Ada 20 pertanyaan yang diajukan penyidik kepada para terduga pelaku pelecehan untuk mendalami kasus dugaan perundungan dan pelecehan seksual di KPI pada 2015 silam. Seiring berjalannya waktu, kelima terduga pelaku akan melaporkan balik MS, korban pelecehan seksual, dengan UU ITE. Kelimanya merasa sudah dirugikan dan namanya tercemar. Selain itu, kelima terduga pelaku pelecehan seksual merasa bukti-bukti yang memberatkan mereka masih terlalu minim.

“Intinya polisi mendalami kejadian di tahun 2015 dan sejauh ini yang kami menemukan tidak ada peristiwa itu. Peristiwa di tahun 2015 yang dituduhkan dan sudah viral tidak ada, tidak didukung bukti apa pun,” kata Tegar lagi. Oleh sebab itu, MS yang melaporkan dugaan pelecehan seksual, akan digugat balik menggunakan UU ITE.

Sementara itu, Komnas HAM siap turun tangan secara langsung untuk menyelidiki kasus perundungan dan pelecehan seksual terhadap MS. Diduga, ada pembiaran dari pihak KPI maupun kepolisian. Hingga kemudian MS akan digugat balik menggunakan UU ITE.

“Karena kami melihat ada dugaan pembiaran dan korban tidak ditangani dengan baik,” tegas Beka Ulung Hapsara, Komisioner Komnas HAM, seperti dikutip voi.id.

Kamis, 07 Januari 2021

Penerapan E-Business

 E-Business merupakan kegiatan berbisnis di Internet yang tidak saja meliputi pembelian, penjualan dan jasa, tapi juga meliputi pelayanan pelanggan dan kerja sama dengan rekan bisnis (baik individual maupun instansi).

E-business diturunkan dari istilah seperti “e-mail” dan “e-commerce”, yaitu bisnis diinternet. E-business adalah istilah yang lebih umum dari e-commerce karena tidak hanya mengarah pada aktifitas membeli dan menjual melainkan melayani konsumen dan bekerja sama dengan rekan-rekan bisnis lainnya atau dengan kata lain E-business merupakan interaksi dengan rekan-rekan bisnis.
Fungsi dari E-business yaitu untuk mensupport bagian dari marketing, produksi, accounting, finance, dan human resource management. Proses transaksi online memegang peranan yang sangat penting pada e-business.
Fenomena E-business telah menjadi trend yang mewarnai aktifitas bisnis baik di negara maju maupun berkembang. Konsep e-business berkembang karena kemajuan teknologi informasi dan E-business ini dianggap sebagai paradigma baru sebagai kunci sukses perusahaan di era informasi dan masa datang.
Banyak definisi tentang E-business yang terdapat dalam literatur dan internet.

Berikut ini adalah beberapa di antaranya:
1. E-business adalah praktek  pelaksanaan dan pengelolaan  proses  bisnis  utama seperti  perancangan  produk, pengelolaan pasokan bahan baku, manufaktur, penjualan, pemenuhan pesanan, dan  penyediaan servis melalui penggunaan teknologi  komunikasi, komputer, dan data yang telah terkomputerisasi.
2. E-business meliputi semua hal yang harus dilakukan menggunakan teknologi informasi dan  komunikasi  (ICT)  untuk  melakukan  kegiatan  bisnis  antar organisasi  maupun  dari  organisasi  ke  konsumen.
3. E-business adalah mengenai penggunaan teknologi internet untuk melakukan transformasi proses bisnis yang dilakukan. Bentuk e-business yang paling mudah terlihat adalah pembelian barang secara online baik retail maupun grosir.
4. Definisi e-business menurut IBM adalah sebuah pendekatan yang aman, fleksibel, dan terintegrasi untuk memberikan nilai bisnis yang berbeda dengan mengkombinasikan sistem dan proses yang menjalankan operasi bisnis utama dengan pemanfaatan teknologi internet.

Strategi E-bussiness
1. Fokus. Produk-produk yang dijual di internet harus menjadi bagian yang fokus dari masing-masing manajer produk.
2. Banner berupa teks, karena respons yang diperoleh dari banner berupa teks jauh lebih tinggi dari banner berupa gambar.
3. Ciptakan 2 level afiliasi. Memiliki distributor penjualan utama dan agen penjualan kedua yang membantu penjualan produk/bisnis.
4. Manfaatkan kekuatan e-mail. E-mail adalah aktivitas pertama yang paling banyak digunakan di Internet, maka pemasaran dapat dilakukan melalui e-mail atas dasar persetujuan.
5. Menulis artikel. Kebanyakan penjualan adalah hasil dari proses edukasi atau sosialisasi, sehingga produk dapat dipasarkan melalui tulisan-tulisan yang informatif.
6. Lakukan e-Marketing. Sediakan sebagian waktu untuk pemasaran secara online.
7. Komunikasi instan. Terus mengikuti perkembangan dari calon pembeli atau pelanggan tetap untuk menjaga kepercayaan dengan cara komunikasi langsung.

Model E-Business
Ada dua jenis model E-Business yang diketahui, yaitu :
  • B2C (Business to Consumers), Interaksi yang dimungkinkan oleh teknologi antara individu dan organisasi. B2C, dapat diartikan sebagai jenis perdagangan elektronik dimana ada sebuah perusahaan (business) yang melakukan penjualan langsung barang-barangnya kepada pembeli (consumer). Kesuksesan dari B2C pada dasarnya dikarenakan faktor penawaran barang kualitas tinggi dengan harga murah dan banyak pula dikarenakan pemberian layanan kepada konsumen yang cukup baik.
  • B2B (Business to Business), bisnis yang dilakukan sebuah perusahaan dengan perusahaan lain(antara perusahaan) baik itu perusahaan yang bergerak pada bidang industri yang sama ataupun berbeda dengan menggunakan media Internet. B2B biasa dilakukan untuk menghemat biaya transaksi. Sebagai contoh perusahaan A ingin memesan sejumlah unit komputer pada perusahaan B, maka perusahaan A dapat mengakses situs resmi perusahaan B dan menuliskan pesanannya. Perusahaan B yang mendapatkan pesan pemesanan barang tersebut akan mengirimkan barang yang dimaksud. Pembayaran biasanya dilakukan berdasarkan kesepakatan sebelumnya. Meskipun tentu saja pemesanan barang ini dapat dilakukan dengan mengangkat telepon.
Penerapan E-Business di Indonesia
Perusahaan dituntut untuk dapat secara optimal membentuk suatu sistem dan melakukan koordinasi, baik di dalam suatu fungsi perusahaan ataupun antar fungsi-fungsi yang dimiliki oleh perusahaan. Pengembangan fungsi-fungsi yang dimiliki oleh perusahaan berjalan seiring dengan perkembangan teknologi informasi dan komunikasi. Sebagai contoh, teknologi jaringan telah mampu merubah paradigma lingkungan bisnis dari fisik menjadi electronic business. Telah banyak perusahaan yang menggunakan teknologi informasi untuk mengembangkan cross functional enterprise systems yang mengintegrasikan fungsi-fungsi bisnis secara tradisional yang dimilikinya guna melakukan reengineer dan meningkatkan proses bisnis yang utama dalam perusahaan. Cross functional enterprise system yang dilakukan oleh perusahaan berkaitan dengan enterprise resources planning, customer relationship management, enterprise application integration, supply chain management dan enterprise collaboration systems. Penerapan e-business system dalam perusahaan biasanya menggunakan bantuan software, dimulai penerapannya pada fungsi per fungsi kemudian berkembang antar fungsi yang menjadi cross-funtional client/server
application.

Paradigma E-Business saat ini menjadi trend teknologi informasi yang digunakan oleh perusahaan-perusahaan besar di Indonesia. Keuntungan yang diharapkan dapat diperoleh perusahaan dengan  menerapkan E-business adalah untuk meningkatkan tingkat efisiensi dan efektivitas perusahaan, memperluas jangkauan dan ruang gerak perusahaan serta meningkatkan peluang perusahaan untuk menciptakan produk dan jasa yang baru.
Penerapan E-business pada perusahaan di Indonesia diaplikasikan dalam beberapa sistem perusahaan yang meliputi :
1. Sistem  Fungsi  Bisnis  (Functional  Business  System),  yang  terdiri  dari  sistem marketing,  sistem  sumber daya
2. Manusia, sistem manajemen  keuangan,  sistem akutansi dan sistem manufaktur
3. Sistem Kerjasama Perusahaan (Enterprise Collaboration System)
4. Sistem Transaksi (Transaction Processing System)
5. Integrasi Aplikasi Perusahaan (Enterprise Application Integration)

Perkembangan E-bussines di Indonesia
Bisnis yang memanfaatkan media Internet ini pada umumnya di Indonesia menggunakan model E-bisnis seperti BtoB (business to business), BtoC (business to customer), CtoC (costumer to costumer). Internet Bisnis, data processing dan jasa informasi lainnya menurut, INC-media bisnis terkemuka di Amerika, menetapkan peringkat ke 1 dalam kategori bisnis yang memiliki prospek paling menjanjikan hingga lebih dari 10 tahun mendatang. Adapun jenis-jenis Bisnis internet yang berkembang saat ini antara lain:
· Bisnis Affiliate Marketing
· Bisnis Reseller
· Jual Produk Informasi
· Google Adsense

Perusahaan yang menerapkan E-business di Indonesia
1. Toko Bagus
Toko Bagus memberikan fasilitas gratis bagi yang akan membeli ataupun menjual barang dan jasa. Fasilitas gratis ini tentunya lebih baik dan lebih bagus jika di bandingkan dengan pemasangan iklan atau membuat sebuah toko online sendiri. Karena selain user tidak di kenakan biaya sepeserpun, proses pasang iklan pada toko bagus pun bisa berlangsung sangat cepat karena pemasang iklan bisa langsung memasang iklannya sendiri di toko bagus. Toko bagus juga merupakan solusi tepat untuk yang ingin mengembangkan pemasaran barang atau jasa secara online tanpa diruwetkan oleh pembuatan toko online. Karena setelah terdaftar menjadi user di toko bagus, maka akan mendapatkan sebuah toko online milik user sendiri dengan alamat domain username.tokobagus.com. Hal ini tentunya sangat menguntungkan para pelaku ekonomi, karena tanpa mengeluarkan biaya sudah bisa memiliki sebuah toko online dari toko bagus yang bisa dipromosikan.

2. Indonesia Air Asia (www.airasia.com)
Melalui airasia.com, maka customer hanya perlu mengakses situs tersebut untuk melakukan reservasi tiket pesawat, bahkan lebih jauh lagi mereka dapat melakukan reservasi hotel dan berbagai paket menarik yang ditawarkan oleh Air Asia. E-business terbaik di Indonesia saat ini adalah e-business yang dimiliki oleh perusahan penerbangan Indonesia Air Asia, yaitu www.airasia.com. Alasan memilih Air Asia adalah karena keunggulan sistem e-business yang dimilikinya, yaitu:
  • Dengan sistem e-business, Air Asia dapat melakukan efisiensi biaya seperti komisi untuk travel agent.
  • Dengan e-business, Air Asia tidak perlu membuat sistem Human Resource sebanyak pada perusahaan penerbangan lainnya.
  • E-business yang diterapkan Air Asia termasuk dalam Business to Consumer dimana aplikasi ini  ditujukan agar konsumer dapat langsung berhubungan dengan pihak perusahaan tanpa harus melalui perantara seperti sistem reservasi konvensional.
  • Penerapan e-business pada Air Asia memberikan keuntungan baik untuk pihak perusahaan maupun bagi pihak customer.
  • Sistem yang digunakan sebagai Point of Sales disebut dengan Global Distribution System (GDS) dimana GDS ini memiliki interface yang berupa Graphical User Intrface (GUI) yang berhadapan langsung dengan pelanggan. Saat pelanggan berinteraksi dengan sistem melalui GUI, maka sistem tersebut secara real-time akan melakukan proses-proses back office diantaranya melakukan validasi, otorisasi, dan konfirmasi yang akhirnya akan memberikan pelanggan suatu bukti penjualan tiket dan bukti tersebutlah yang digunakan sebagai tiket pesawat.
3. PT. Garuda Indonesia
Garuda Indonesia merupakan maskapai penerbangan terbesar dan terbaik di Indonesia yang telah menerapkan e-business dalam supply chain management. Garuda Indonesia pernah berhasil melakukan e-auction untuk pengadaan bahan bakar jet dengan nilai transaksi mencapai US$ 54 juta.

Jumat, 03 Juli 2020

Manusia dan Tanggung Jawab

Tanggung jawab adalah kesadaran manusia akan tingkah laku atau  perbuatan yang disengaja maupun yang tidak di sengaja. Tanggung jawab juga berarti berbuat sebagai perwujudan kesadaran akan kewajiban. Tanggung jawab bersifat kodrati, artinya sudah menjadi bagian kehidupan manusia, bahwa setiap manusia pasti dibebani dengan tanggung jawab. Apabila ia tidak mau bertanggung jawab, maka ada pihak lain yang memaksa tanggung jawab itu. Dengan demikian tanggung jawabitu dapat dilihat dari dua sisi yaitu dari sisi yang berbuat dan dari sisi yang kepentingan pihak lain. Dari sisi si pembuat ia harus menyadari akibat perbuatannya itu dengan demikian ia sendiri pula yang harus memulihkan ke dalam keadaan baik. Dari sisi pihak lain apabila si pembuat tidak mau bertanggung jawab, pihak lain yang akan memulihkan baik dengan cara individual maupun dengan cara kemasyarakat. Tanggung jawab adalah ciri manusia beradab (berbudaya). Manusia merasa bertanggung jawab karena ia menyadari akibat baik atau buruk perbuatannyaitu, dan menyadari pula bahwa pihak lain memerlukan pengabdian atau pengorbanannya. Untuk memperoleh atau meningkatkan kesadaran bertanggung jawab perlu ditempuh usaha melalui pendidikan, penyuluhan, keteladanan dan takwa kepada Tuhan Yang Maha Esa.

MACAM-MACAM TANGGUNG JAWAB
  1. Tanggung jawab terhadap diri sendiri
      Tanggung jawab terhadap diri sendiri menentukan kesadaran setiap orang untuk memenuhi kewajibannya sendiri dalam mengembangkan kepribadian sebagai manusia pribadi. Dengan demikian bisa memecahkan masalah-masalah kemanusiaan mengenai dirinya sendiri menurut sifat dasarnya manusia adalah mahluk bermoral, tetapi manusia juga pribadi.
  2. Tanggung jawab terhadap keluarga
      Keluarga merupakan masyarakat kecil. Keluarga terdiri dari suami, istri, ayah, ibu anak-anak, dan juga orang lain yang menjadi anggota keluarga. Tiap anggota keluarga wajib bertanggung jawab kepada keluarga. Tanggung jawab ini menyangkut nama baik keluarga. Tetapi tanggung jawab juga merupakan kesejahteraan, keselamatan dan kehidupan.
  3. Tanggung jawab terhadap masyarakat
      Pada hakekatnya manusia tidak bisa hidup tanpa bantuan manusia lain, sesuai dengan kedudukannya sebagai mahluk sosial. Karena membutuhkan manusia lain maka ia harus berkomunikasi dengan manusia lain. Sehingga dengan demikian manusia disini merupakan anggota masyarakat yang tentunya mempunyai tanggung jawab seperti anggota masyarakat yang lain agar dapat melangsungkan hidupnya dalam masyrakat tersebut.
  4. Tanggung jawab kepada Bangsa / negara
      Suatu kenyataan lagi, bahwa tiap manusia, tiap individu adalah warga negara suatu negara. Dalam berpikir, berbuat, bertindak, bertingkah laku manusia tidak dapat berbuat semaunya sendiri. Bila perbuatan itu salah, maka ia harus bertanggung jawab kepada negara.
  5. Tanggung jawab terhadap Tuhan
      Tuhan menciptakan manusia di bumi ini bukanlah tanpa tanggung jawab, melainkanuntuk mengisa kehidupannya manusia mempunyai tanggung jawab lngsung terhadap Tuhan. Sehingga tindakan manusia tidak bisa lepas dari hukum-hukum Tuhan yang dituangkan dalam berbagai kitab suci melalui berbagai macam agama. Pelanggaran dari hukum-hukum tersebut akan segera diperingatkan oleh Tuhan dan juka dengan peringatan yang keraspun manusia masih juga tidak menghiraukan maka Tuhan akan melakukan kutukan.

PENGABDIAN DAN PENGORBANAN
 1. Pengabdian
Pengabdian itu adalah perbuatan baik yang berupa pikiran, pendapat ataupun tenaga sebagai perwujudan kesetiaan, cinta, kasih sayang, hormat, atau satu ikatan dan semua itu dilakukan dengan ikhlas. Pengabdian itu hakekatnya adalah rasa tanggung jawab, apabila orang bekerja keras sehari penuh untuk mencukupi kebutuhan, hal itu berarti mengabdi kepada keluarga. Lain halnya jika kita membantu teman dalam kesulitan, mungkin sampai berhari-hari itu bukan pengabdian, tetapi hanya bantuan saja. Pengabdian lebih banyak menunjuk kepada perbuatan sedangkan, pengorbanan lebih banyak menunjuk kepada pemberian sesuatu misalnya berupa pikiran, perasaan, tenaga, biaya, waktu. Dalam pengabdian selalu dituntut pengorbanan belum tentu menuntut pengabdian.
 2. Pengorbanan
Pengorbanan berasal dari kata korban atau kurban yang berarti persembahan, sehingga pengorbanan berarti pemberian untuk menyatakan kebaktian. Dengan demikian pengorbanan yang bersifat kebaktian itu mengandung unsur keikhlasan yang tidak mengandung pamrih suatu pemberian yang didasarkan atas kesadaran moral yang tulus ikhlas semata-mata. Pengorbanan dalam arti pemberian sebagai tanda kebaktian tanpa pamrih dapat dirasakan bila kit membaca atau mendengarkan kotbah agama. Dari kisah para tokoh agama atau nabi, manusia memperoleh tauladan, bagaimana semestinya wajib berkorbanan. Pengorbanan merupakan akibat dari pengabdian. Pengorbanan dapat berupa harta benda, pikiran, perasaan, bahkan dapat juga berupa jiwanya. Pengorbanan diserahkan secara ikhlas tanpa pamrih, tanpa ada perjanjian, tanpa ada transaksi, kapan saja diperlukan.

Macam – Macam Pengorbanan :
1. Pengorbanan harta benda
2. Pengorbanan pikiran
3. Pengorbanan perasaan
4. Pengorbanan tenaga

Jadi makna dari pengorbanan itu sendiri adalah:
1. Bisa membantu hidup atau masalah seseorang menjadi lebih baik.
2. Pengorbanan adalah suatu tindakan yang mulia.
3. Pengorbanan yang diberikan akan sangat berharga dan berguna sekali untuk orang yang mendapat pertolongan atau pengorbanannya, walau pengorbanan yang diberikan sedikit.

Minggu, 31 Mei 2020

Manusia sebagai Makhluk Berbudaya

Manusia adalah makhluk budaya artinya makhluk yang berkemampuan menciptakan kebaikan, kebenaran, keadilan dan bertanggung jawab. Sebagai makhluk berbudaya, manusia mendayagunakan akal budinya untuk menciptakan kebahagiaan baik bagi dirinya maupun bagi masyarakat demi kesempurnaan hidupnya. Sebagai catatan bahwa dengan pikirannya manusia mendapatkan ilmu pengetahuan. Dengan kehendaknya manusia mengarahkan perilakunya dan dengan perasaannya manusia dapat mencapai kebahagiaan.
Adapun sarana untuk memelihara dan meningkatkan ilmu pengetahuan dinamakan LOGIKA. Sarana untuk meningkatkan dan memelihara pola perilaku dan mutu kesenian adalah ETIKA dan ESTETIKA.
Tujuan dari pemahaman bahwa manusia sebagai makhluk budaya, agar dapat dijadikan dasar pengetahuan dalam mempertimbangkan dan mensikapi berbagai problematic budaya yang berkembang di masyarakat sehingga manusia tidak semata-mata merupakan makhluk biologis saja namun juga sebagai mahluk social, ekonomi, politik dan mahluk budaya.
Pengertian kebudayaan ditinjau dari bahasa Sansakerta “budhayah” (jamak), budhi = budi/akal. Jadi kebudayaan adalah hasil akal manusia untuk mencapai kesempurnaan. EB. Taylor mengartikan kebudayaan sebagai “keseluruhan kompleks yang di dalamnya terkandung ilmu pengetahuan serta yang di dapat manusia sebagai anggota masyarakat. Atau diartikan pula segala sesuatu yang diciptakan manusia baik materi maupun non material melalui akal". Budaya itu tidak diwariskan secara generative (biologis) tapi melalui belajar. Dengan hasil budaya manusia, maka terjadilah pola kehidupan. Pola kehidupan inilah yang menyebabkan hidup bersama dan dengan pola kehidupan ini dapat mempengaruhi cara berfikir dan gerak social. Dengan memfungsikan akal budinya dan pengetahuan kebudayaannya, manusia bisa mempertimbangkan dan menyikapi problema budayanya. 
Kebudayaan perlu dikaji agar kita bias mengembangkan kepribadian dan wawasan berfikir. Kebudayaan diciptakan manusia dengan tujuan untuk memenuhi kebutuhan manusia dalam rangka mempertahankan hidup serta meningkatkan kesejahteraannya. Dalam proses perkembangan kebudayaan terjadi pula penyimpangan dari tujuan penciptaan kebudayaan yang disebut MASALAH KEBUDAYAAN. Masalah kebudayaan adalah segala system/tata nilai, sikap mental, pola berfikir pola tingkah laku dalam berbagai aspek kehidupan yang tidak memuaskan bagi warga masyarakat secara keseluruhan. Masalah tata nilai dapat menimbulkan kasus-kasus kemasyarakatan antara lain : DEHUMANISASI, artinya pengurangan arti kemanusiaan seseorang. Jadi kita melihat Dehumanisasi terjadi akibat perubahan sikap manusia sebagai dampak dari penyimpangan tujuan pengembangan kebudayaan. Untuk mengantisipasi hal itu, manusia harus dikenalkan pada pengetahuan kebudayaan dan filsafat. Melalui filsafat bias memaknai tentang etika, estetika dan logika.